Удаление старого кода, ревизия экспериментов и ускорение CI: опыт команды Core Experimentation в OpenAI.
Rodrigo RoimGPT-6 Astra / GPT-6.1 SolКонспект · ~6 минут
Главная идея
Агент ищет кандидатов, собирает доказательства и готовит небольшие изменения. Человек проверяет назначение кода и пользу удаления. Масштаб аудита растёт после успешных проб.
Отсутствие прямых вызовов ещё не доказывает, что код лишний: рефлексия скрывает связи, а редкий путь может понадобиться при инциденте.
С GPT-5.6 Sol автор задавал область поиска и чёткие критерии проверки. GPT-6 Astra справилась с более широким запросом: сама изучала прежние PR, Slack, внутренние трекеры и профили выполнения в production. Объяснение каждого удаления ускоряло ревью.
01 / КандидатНеиспользуемый код или устаревший эксперимент
02 / ДоказательстваКод + история + живые настройки + телеметрия
03 / Малый PRОбоснование и ревью команды-владельца
04 / Обратная связьИзмерить эффект, уточнить следующий запрос
Схема конспекта: порядок работы, собранный из примеров автора.
Более 1 400 PR
Пять инженеров удалили свыше 800 тыс. строк. Основную работу сделали за две недели, параллельно с другими проектами; ревью распределяли между командами.
3,31 → 1,72 ГБ
Образ одного сервиса уменьшился на 48%. Другие удаления убрали около 400 вариантов визуальных снимков из тестов.
Завершённый эксперимент иногда продолжает исполняться в production. Его условия включения могут меняться, поэтому статический анализ пропускает часть кандидатов.
Проверить реальную конфигурацию
Сопоставить настройки Statsig, историю Git и пересекающиеся PR. Сохранить поведение production, защитные механизмы и killswitch — аварийные переключатели. Не принимать SDK fallback и локальный override за живую конфигурацию.
Проследить непрямые связи
Проверить enum, константы, обёртки, псевдонимы, схемы, динамические имена и потребителей в других сервисах. Проверять весь инвентарь, а не только объекты с меткой stale.
Для большого аудита автор запросил отчёт: значения в production, доказательства, владельцы, места вызовов и измеренные затраты CPU. Кандидатов сгруппировали по владельцам и файлам для независимой работы. Менять живые конфигурации и сервисы в ходе аудита запретили.
Одна строка, много вычислений
Старый флаг для внутренних разработчиков переопределял все остальные флаги новых функций. Одна строка связывала его со всеми функциями и создавала значительные затраты CPU.
Astra увидела метку Permanent и передала решение человеку. После ревью флаг удалили; ожидаемая экономия CPU основного затронутого сервиса составила 0,42%.
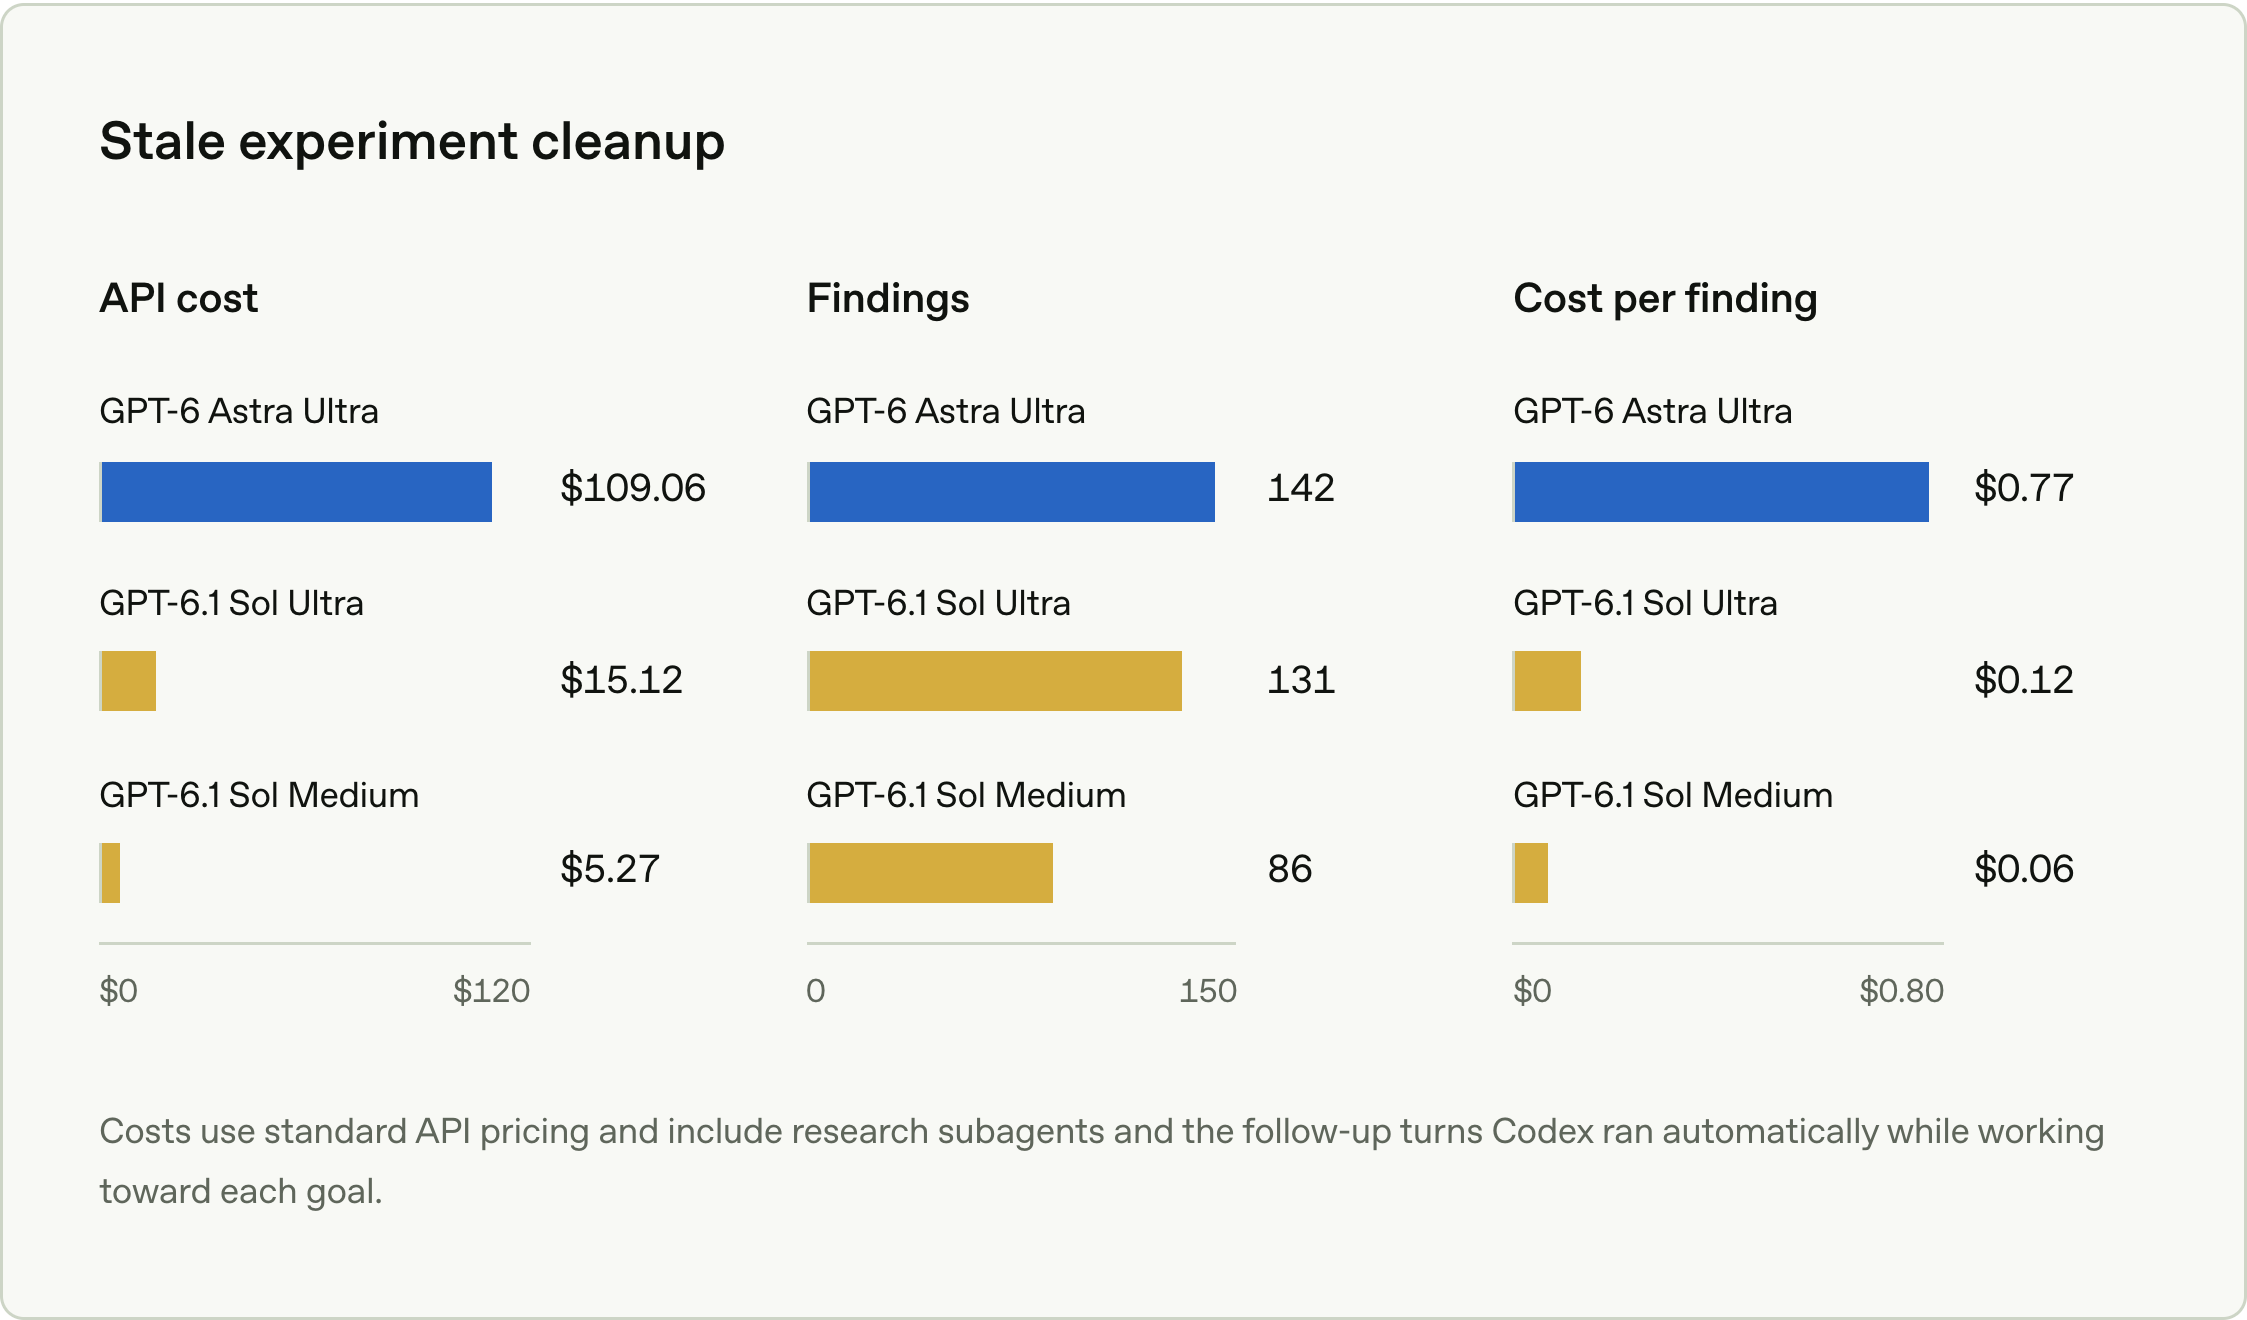
Один запрос, разные модели и уровни effort. Проверенные автором результаты аудита каталогов: более 6 000 файлов, около 1 млн строк на Python, TypeScript, Go и Rust.
92% находок / 14% стоимости
Так Sol Ultra соотносилась с Astra Ultra в этом сравнении. Sol Medium стоила ещё меньше, но нашла меньше подтверждённых кандидатов.
Проверять, что именно пропущено
Большинство расхождений между Ultra касалось постоянных флагов, от которых зависели другие флаги: Astra находила их, Sol пропускала.
Результаты из статьи · USD
Модель / effort
API
Находки
За находку
GPT-6 Astra Ultra
$109,06
142
$0,77
GPT-6.1 Sol Ultra
$15,12
131
$0,12
GPT-6.1 Sol Medium
$5,27
86
$0,06
Стоимость рассчитана по стандартным тарифам API и включает исследовательских субагентов и автоматические продолжения работы Codex. Это стоимость конкретных запусков из статьи.
График автора, сохранённый со страницы. Нажмите для увеличения. В статье ↗
Паттерны пропусков помогают уточнять запросы для более дешёвой модели. После выхода новой модели эти поправки нужно пересматривать: прежнее ограничение может исчезнуть.
Изучить недавние запуски CI, найти простые причины случайных падений и подготовить PR для удачных исправлений. Не пытаться исправить сразу все нестабильные тесты.
Инструкции AGENTS.md
Найти одну инструкцию, которая мешала агенту. Повторить исходный запрос дважды с той же моделью и снимком репозитория: до и после изменения только этой инструкции. Сравнить качество, действия, вызовы инструментов, токены, время и стоимость.
Нагрузка CI
Ранжировать идеи по ожидаемому числу сэкономленных минут CI в сутки, используя историю запусков репозитория.
Автор предлагает начинать такие пробы с GPT-6.1 Sol Medium и повышать effort для более широкого аудита, если первый результат полезен.
Медиана: ~10 → 4,5 мин
После примерно 30 PR с оптимизациями CI 90-й перцентиль также снизился: с 12,5 до 6 минут.
592,6 → 29,8 секунды
В отдельном исправлении добавили отсутствующий mock. Набор из 63 тестов resolver ускорился на 95%; все тесты сохранили.
Практический план по мотивам статьи. Начните с одной задачи, для которой сможете проверить доказательства и результат.
Выберите небольшой участок. Один подозрительный флаг, неиспользуемый модуль или нестабильный тест. Зафиксируйте ожидаемое поведение и защитные механизмы.
Запросите доказательства. Дайте доступ к нужным настройкам, истории и телеметрии. Попросите явно назвать неопределённости и подготовить небольшой draft PR.
Сравните две конфигурации модели. На той же задаче оцените подтверждённые находки, пропуски и стоимость. Более дешёвого варианта может хватить.
Проведите ревью и измерьте пользу. Для удаления проверьте сохранность поведения; для оптимизации сравните время CI, размер образа или CPU. Откажитесь от изменений, чья сложность не окупается.
Расширяйте область постепенно. Внесите замечания ревью в следующий запрос. Перейдите от задачи к каталогу, затем к проекту и всей базе. Большой список ранжируйте по измеримому эффекту.
Адаптированный запрос · авторский пример конспектаВ статье ↗
Исследуй [каталог] и найди один устаревший флаг.
Проверь живую конфигурацию, историю, непрямые использования
и назначение защитных механизмов. Сохрани поведение production.
Если данных не хватает, перечисли пробелы.
Подготовь небольшой draft PR с доказательствами и планом проверки.
Не меняй живые конфигурации и сервисы.